ラベル 正規表現 の投稿を表示しています。 すべての投稿を表示

2017年10月27日金曜日

スタイル チェック テクニック - カタカナ複合語

カタカナ複合語間にスペースや中黒を入れない案件では、次の正規表現でスタイル エラーを検出できます。正規表現エンジンに文字クラスが定義されているときは、できるだけ使用しましょう。

.NET 表現: \p{IsKatakana}[\s・·]+\p{IsKatakana}
Perl: [\p{Katakana}ー][\s・·]+[\p{Katakana}ー]
汎用表現: [ァ-ヶー][\s・·]+[ァ-ヶー]

では、スペースありの案件では、どのようにしたらよいのでしょうか。過去に、正規表現で検出しようとしたことがあります。

過去のボツ手法

1. カタカナ語を抽出して、データベースを作成する。
2. 次のような正規表現を頑張って作成します。

[ァ-ヶー](エンジン|コンピュータ[ー]?|テキスト|(?<!コン)テキスト|コンテキスト|ヘルプ|インストール|ウィンドウ|アイコン|エディタ|フォルダ|(?<!プロ)ファイル|プロファイル|ダイアログ|(?<!プレ)ビュー|(?<!プ)レビュー|プレビュー|ボタン|システム|(?<!ル)クリック|(?<!データ)ベース|ベース|データ|フィールド|ユーザ[ー]?|アクセス|ステータス|ライセンス|サーバ[ー]?|アプリケーション|アクティベーション)|(エンジン|コンピュータ[ー]?|テキスト|(?<!コン)テキスト|コンテキスト|ヘルプ|インストール|ウィンドウ|アイコン|エディタ|フォルダ|(?<!プロ)ファイル|プロファイル|ダイアログ|(?<!プレ)ビュー|(?<!プ)レビュー|プレビュー|ボタン|システム|(?<!ル)クリック|(?<!データ)ベース|ベース|データ|フィールド|ユーザ[ー]?|アクセス|ステータス|ライセンス|サーバ[ー]?|アプリケーション|アクティベーション)[ァ-ヶ]

3. めんどくさい。誤検出も多く、正規表現のブラッシュアップも大変。PC を窓から発射したくなるのでやめた。

現在の手法

現在はテキスト エディタを使用してチェックしています。「自動検証が無理なら、手動検証を楽にすればいいじゃない」というわけです。高機能エディタであれば、この操作が可能です。必須機能は、正規表現、並べ替え、重複削除です。

1. 全訳文をテキスト エディタに貼り付けます。
2. カタカナ語以外を改行に変換します。
3. 並べ替えます。
4. 重複を削除します。
5. エラーを簡単に確認できる状態になります。

Sakura Editor を使用している場合は、次のマクロを使用して簡単に処理できます。10 万語くらいは一瞬で、1 億語でも 30 秒程度で処理が完了します。

//キーボードマクロのファイル
S_ReplaceAll('[^ァ-ヶ]ー', '', 28); // カタカナ語以外に続く長音を削除
S_ReplaceAll('[^ァ-ヶー\\s]+|[\\s\\r\\n]+', '\\r\\n', 28); // カタカナ語以外をすべて改行に置換
S_ReDraw(0); // 再描画
S_SelectAll(0); // すべて選択
S_SortAsc(0); // 選択行の昇順ソート
S_Merge(0); // 連続した重複行の削除
S_GoFileTop(0); // ファイルの先頭に移動

この手法の利点

実際の 50 万語の案件では、カタカナ語は約 1000 種類でした。これだけ多くても、次に示すように、エラーを簡単に視認できるので、チェック自体には数分しかかかりません。 実際に試してみれば、かなりのスクロール速度でチェックできることがわかると思います。

...
コンソール
コンテキスト
コンテナ
コンテンツ
コントロール
コントロールパネル
コンパイラ
コンパイル
コンパニオン
コンピュータ
コンプレックス
コンポーネント
コーディング
...

本来の意図とは異なりますが、類似語が連続して表示されるので、単語の末尾にある長音の有無、タイポ、表記揺れなどの一部も発見できます。

まとめ

語数の多い案件では、必ずと言ってよいほどカタカナ複合語のスタイル違反が見つかります。リリース後の文書からも発見されます。しっかりと処理しないと、検索や索引作成に影響します。

こういう手法もあることを知っておけば、いつか役に立つかもがネギしょって鍋にバンジー。


2017年5月19日金曜日

ハイフンの重箱の隅

どうもです。ハイフンについて重箱の隅をつついてからペロペロしておこうと思います。

受注した案件のスタイルガイドに、次のような指示があった場合、皆さんどのように処理しますか。

「減算記号にはハイフンを使ってください」
「減算記号には半角ダッシュを使用してください」

言語を仕事にしている会社が書いてよい文章ではないですね。いろいろと問題のある記述ではありますが、まぁほとんどの場合、スタイルガイドの意図は「ハイフンマイナス」という記号です。つまり、キーボートで直接入力できるハイフンマイナス (Hyphen-Minus、\u002D) のことです。


「-」ハイフンマイナス (Hyphen-Minus) \u002D
キーボードの英数モードで直接入力できる ASCII 文字で、ハイフンとマイナスの両方に使用されてきました。事実上の "標準ハイフン" および "標準マイナス" です (少なくとも私の分野では)。

これだけなら、「ハイフン = ハイフンマイナス」と脳内変換すればいいのですが、厄介なことに、「ハイフン」という名称の記号もあります。


「‐」ハイフン (Hyphen) \u2010
なんでこんな名称にしたのでしょう...。MS IME では、「ハイフン[全]」表示を選択して入力できます。

名前こそハイフンですが、ASCII には含まれていません。そのため、使用できない場面が多々あります。制限の多い組み込み機器の UI なんかには使用できないんじゃないかな。まぁ、IT 系で「ハイフン」と書かれている場合は、通常、ハイフンマイナスのことです。

ですが、英文の DTP を海外に発注し、DTPer に「減算記号はすべて Hyphen に変更」と指示して、\u2010 を使用されても文句は言えません (実際は起こらないと思いますが)。

まぁ、「ハイフン」という言葉を \u2010 のつもりで記載しているスタイルガイドはないと思いますが、他の演算記号が全角になっているなど、すごく怪しい場合は問い合わせた方が安心です。


ハイフンの種類

次のように、似ている記号がたくさんあります (赤がハイフンマイナス)。
‐-‑⁃
\u2010\u002D\u2011\u2043


正規表現

ハイフンマイナスの亜種 (というか類似記号) は、以前紹介した次の表現で検出できます。再び説明しておくと、基本ラテン語ブロックと、標準的な日本語関連ブロックから外れた文字を検出する正規表現です。半角カタカナ、全角数字、全角記号、特殊記号、日英以外の文字が検出されます。

基本ラテン文字に存在する記号の全角バージョンは、基本的に特殊文字として扱われます。例外にする場合は、赤字の部分に追加してください。日本語固有のかぎ括弧類は標準の範囲に含まれています。

.NET
[^\p{IsBasicLatin}\p{IsCJKUnifiedIdeographs}\p{IsHiragana}\p{IsKatakana}\p{IsCJKSymbolsandPunctuation}~™®]

Perl
[^\x{0000}-\x{007F}\x{4E00}-\x{9FFF}\x{3040}-\x{30FF}\x{3000}-\x{303F}~™®]

ハイフンマイナス以外の類似記号がすべて検出されます。ダッシュは種類を問わず、すべて検出されます。日本語には形が類似している「ー」(長音) や「一」(いち) が存在し、また読みやすさに貢献する場面を見たことがないので、私は基本的にダッシュを使用しません。許容する人は赤字の部分に追加する必要があります。

それなりのボリュームの訳文やメモリに使ってみれば、標準以外のハイフンの混在が意外に多いことに気づくでしょう。

ちなみに私は、どのような案件に対しても、この正規表現または改変版を必ず使用しています。


この記事で言いたかったこと

「世の中の記号をすべて正式名で呼べ」と主張しているわけではありません。日常生活やブログで、ハイフンマイナスをハイフンと呼んでも、正直、どーでもいいんです。

ただし、翻訳という生産物を作成するためのワークフロー内では許されないと思います。

冒頭に記載した「半角ダッシュ」ですが、正直なんのことやら。en Dash も em Dash も表示は半角です。Hypehn-minus の社内俗称なのか、各種ダッシュ (‒、–、—、―) のいずれかを指しているのか、さっぱりわかりません...。

類似記号の多いハイフンやマイナスなどの指示を記述する場合は、翻訳者に誤解を与えないよう配慮する必要があります。つまり、実際の文字を記載するか、コード ポイントを併記する必要があります。


2017年5月12日金曜日

翻訳者と校正者のための正規表現 (16) - 常用漢字以外の検出

常用外の漢字と用法を検出する正規表現を、コツコツと作成していました。形になったので公開したいと思います。

概要

前に JIS 第 1 水準以外の漢字を検出する正規表現を書きました。ところで、なぜ常用漢字ではなく、JIS にしたのでしょう。はい、それは簡単だからです。ただ並べればいいだけですから。

一方、常用漢字は 2010 年の改訂で、JIS に存在しない文字や 16 ビット超えの文字まで追加されてしまいました。Shift_JIS 環境では、コピペだけで常用漢字の一部が文字化けすることがあります (または別の文字に置換されます)。

そのうえ、「常用漢字表」に準拠するには、漢字の種類だけでなく読みも問題になります。ただ単に漢字を検出すれば済む話ではないのです・・・。

そこで、以下の処理を行いました。
  • Shift_JIS にない文字のコードポイント化
  • よく見られる常用外の用法を検出する表現を追加
これで、まあまあの検出結果が得られるようになりました。もちろん用法の誤検出もあり得ます。おかしいなと思ったら、文化庁発行の「常用漢字表」を参照してください。もちろん、誤検出修正や検出精度向上のために随時更新します。

対象エディタ (正規表現エンジン)

Trados Studio など、.NET エンジンを使用しているエディタなら、そのまま使用できるはずです。Trados の場合は、[検索と置換]、[フィルタ表示]、[高度な表示フィルタ]、[検証] のいずれでも使用できます。

また、エンジン固有の機能 (減算や特殊な名前付きブロック) を使っていないので、その他のエンジンでも多少の変更で利用できます。下記の正規表現の赤字部分を、ご使用のエディタでサポートされる形式に変更してください。

たとえば、Perl 互換のエンジンでは \x{0000} の形式で OK だと思います (Onigmo エンジンしかチェックしてません)。もちろん、この変換にも正規表現を使いましょう。このケースなら、置換前の文字列に「\\u([\d+A-F]+)」、置換後の文字列に「\\x\{$1\}」を入力してポチッとな。Perl 互換系では、Sakura Editor と Mery で動作確認済みです。検索ボックス自体に文字数制限のあるエディタ (VxEditor、Notepad++) では使用できませんでした。

深くは解説しませんが、エディタで \u20B9FF (𠮟) がエラーになる場合は、これを削除するしかないと思います。まぁ、大きな影響はないと思います。興味のある方は「叱」と「𠮟」の違いについてググってください。

検出時の処理と注意

いうまでもなく、人名用漢字というものがあります。これらにヒットしすぎて困るような案件の場合は、人名用の常用外漢字と異体字、および人名用常用漢字の異体字を、漢字部分に追加してください。

検出された常用外の漢字や用法の修正についても、注意事項があります。これについては、別記事「常用漢字表の趣旨」を参照してください。

ライセンス

LGPL にしてみます。まぁ、後で気が変わるかもしれません。翻訳者の方は、「無保証」以外は何も気にせずに使用および改変して翻訳に使用できます。こんなものにライセンスを付けるなんてと思う方もいるでしょうが、単に、改善版が公開され続けることを意図してライセンスを付けてみました。こうしたらもっと良くなるという方は、ぜひ皆さんの Web で公開してください。

エージェントさんも、このコードを自由に使用および改変できます。ただし、配布する際は、翻訳者が何らかの方法で中身を確認できる形態にすることが義務になります。たとえば、Trados Studio の QA Checker にある [正規表現] ボックスに使用してプロジェクトを配布できますが、まったく確認できない形態での配布は許容されません。各種エディタのマクロとしてプレーン テキストで配布することは可能です。

2017/6/20: 「射」用法の誤検出修正
2017/8/16: 「観」用法の誤検出修正

常用外の漢字と用法を検出する正規表現

[^\u0000-\u4DFF\uA000-\uFFFF亜哀挨愛曖悪握圧扱宛嵐安案暗以衣位囲医依委威為畏胃尉異移萎偉椅彙意違維慰遺緯域育一壱逸茨芋引印因咽姻員院淫陰飲隠韻右宇羽雨唄鬱畝浦運雲永泳英映栄営詠影鋭衛易疫益液駅悦越謁閲円延沿炎怨宴媛援園煙猿遠鉛塩演縁艶汚王凹央応往押旺欧殴桜翁奥横岡屋億憶臆虞乙俺卸音恩温穏下化火加可仮何花佳価果河苛科架夏家荷華菓貨渦過嫁暇禍靴寡歌箇稼課蚊牙瓦我画芽賀雅餓介回灰会快戒改怪拐悔海界皆械絵開階塊楷解潰壊懐諧貝外劾害崖涯街慨蓋該概骸垣柿各角拡革格核殻郭覚較隔閣確獲嚇穫学岳楽額顎掛潟括活喝渇割葛滑褐轄且株釜鎌刈干刊甘汗缶完肝官冠巻看陥乾勘患貫寒喚堪換敢棺款間閑勧寛幹感漢慣管関歓監緩憾還館環簡観韓艦鑑丸含岸岩玩眼頑顔願企伎危机気岐希忌汽奇祈季紀軌既記起飢鬼帰基寄規亀喜幾揮期棋貴棄毀旗器畿輝機騎技宜偽欺義疑儀戯擬犠議菊吉喫詰却客脚逆虐九久及弓丘旧休吸朽臼求究泣急級糾宮救球給嗅窮牛去巨居拒拠挙虚許距魚御漁凶共叫狂京享供協況峡挟狭恐恭胸脅強教郷境橋矯鏡競響驚仰暁業凝曲局極玉巾斤均近金菌勤琴筋僅禁緊錦謹襟吟銀区句苦駆具惧愚空偶遇隅串屈掘窟熊繰君訓勲薫軍郡群兄刑形系径茎係型契計恵啓掲渓経蛍敬景軽傾携継詣慶憬稽憩警鶏芸迎鯨隙劇撃激桁欠穴血決結傑潔月犬件見券肩建研県倹兼剣拳軒健険圏堅検嫌献絹遣権憲賢謙鍵繭顕験懸元幻玄言弦限原現舷減源厳己戸古呼固股虎孤弧故枯個庫湖雇誇鼓錮顧五互午呉後娯悟碁語誤護口工公勾孔功巧広甲交光向后好江考行坑孝抗攻更効幸拘肯侯厚恒洪皇紅荒郊香候校耕航貢降高康控梗黄喉慌港硬絞項溝鉱構綱酵稿興衡鋼講購乞号合拷剛傲豪克告谷刻国黒穀酷獄骨駒込頃今困昆恨根婚混痕紺魂墾懇左佐沙査砂唆差詐鎖座挫才再災妻采砕宰栽彩採済祭斎細菜最裁債催塞歳載際埼在材剤財罪崎作削昨柵索策酢搾錯咲冊札刷刹拶殺察撮擦雑皿三山参桟蚕惨産傘散算酸賛残斬暫士子支止氏仕史司四市矢旨死糸至伺志私使刺始姉枝祉肢姿思指施師恣紙脂視紫詞歯嗣試詩資飼誌雌摯賜諮示字寺次耳自似児事侍治持時滋慈辞磁餌璽鹿式識軸七叱\u20B9FF失室疾執湿嫉漆質実芝写社車舎者射捨赦斜煮遮謝邪蛇尺借酌釈爵若弱寂手主守朱取狩首殊珠酒腫種趣寿受呪授需儒樹収囚州舟秀周宗拾秋臭修袖終羞習週就衆集愁酬醜蹴襲十汁充住柔重従渋銃獣縦叔祝宿淑粛縮塾熟出述術俊春瞬旬巡盾准殉純循順準潤遵処初所書庶暑署緒諸女如助序叙徐除小升少召匠床抄肖尚招承昇松沼昭宵将消症祥称笑唱商渉章紹訟勝掌晶焼焦硝粧詔証象傷奨照詳彰障憧衝賞償礁鐘上丈冗条状乗城浄剰常情場畳蒸縄壌嬢錠譲醸色拭食植殖飾触嘱織職辱尻心申伸臣芯身辛侵信津神唇娠振浸真針深紳進森診寝慎新審震薪親人刃仁尽迅甚陣尋腎須図水吹垂炊帥粋衰推酔遂睡穂随髄枢崇数据杉裾寸瀬是井世正生成西声制姓征性青斉政星牲省凄逝清盛婿晴勢聖誠精製誓静請整醒税夕斥石赤昔析席脊隻惜戚責跡積績籍切折拙窃接設雪摂節説舌絶千川仙占先宣専泉浅洗染扇栓旋船戦煎羨腺詮践箋銭潜線遷選薦繊鮮全前善然禅漸膳繕狙阻祖租素措粗組疎訴塑遡礎双壮早争走奏相荘草送倉捜挿桑巣掃曹曽爽窓創喪痩葬装僧想層総遭槽踪操燥霜騒藻造像増憎蔵贈臓即束足促則息捉速側測俗族属賊続卒率存村孫尊損遜他多汰打妥唾堕惰駄太対体耐待怠胎退帯泰堆袋逮替貸隊滞態戴大代台第題滝宅択沢卓拓託濯諾濁但達脱奪棚誰丹旦担単炭胆探淡短嘆端綻誕鍛団男段断弾暖談壇地池知値恥致遅痴稚置緻竹畜逐蓄築秩窒茶着嫡中仲虫沖宙忠抽注昼柱衷酎鋳駐著貯丁弔庁兆町長挑帳張彫眺釣頂鳥朝貼超腸跳徴嘲潮澄調聴懲直勅捗沈珍朕陳賃鎮追椎墜通痛塚漬坪爪鶴低呈廷弟定底抵邸亭貞帝訂庭逓停偵堤提程艇締諦泥的笛摘滴適敵溺迭哲鉄徹撤天典店点展添転\u5861田伝殿電斗吐妬徒途都渡塗賭土奴努度怒刀冬灯当投豆東到逃倒凍唐島桃討透党悼盗陶塔搭棟湯痘登答等筒統稲踏糖頭謄藤闘騰同洞胴動堂童道働銅導瞳峠匿特得督徳篤毒独読栃凸突届屯豚頓貪鈍曇丼那奈内梨謎鍋南軟難二尼弐匂肉虹日入乳尿任妊忍認寧熱年念捻粘燃悩納能脳農濃把波派破覇馬婆罵拝杯背肺俳配排敗廃輩売倍梅培陪媒買賠白伯拍泊迫\u525D舶博薄麦漠縛爆箱箸畑肌八鉢発髪伐抜罰閥反半氾犯帆汎伴判坂阪板版班畔般販斑飯搬煩頒範繁藩晩番蛮盤比皮妃否批彼披肥非卑飛疲秘被悲扉費碑罷避尾眉美備微鼻膝肘匹必泌筆姫百氷表俵票評漂標苗秒病描猫品浜貧賓頻敏瓶不夫父付布扶府怖阜附訃負赴浮婦符富普腐敷膚賦譜侮武部舞封風伏服副幅復福腹複覆払沸仏物粉紛雰噴墳憤奮分文聞丙平兵併並柄陛閉塀幣弊蔽餅米壁璧癖別蔑片辺返変偏遍編弁便勉歩保哺捕補舗母募墓慕暮簿方包芳邦奉宝抱放法泡胞俸倣峰砲崩訪報蜂豊飽褒縫亡乏忙坊妨忘防房肪某冒剖紡望傍帽棒貿貌暴膨謀\u9830北木朴牧睦僕墨撲没勃堀本奔翻凡盆麻摩磨魔毎妹枚昧埋幕膜枕又末抹万満慢漫未味魅岬密蜜脈妙民眠矛務無夢霧娘名命明迷冥盟銘鳴滅免面綿麺茂模毛妄盲耗猛網目黙門紋問冶夜野弥厄役約訳薬躍闇由油喩愉諭輸癒唯友有勇幽悠郵湧猶裕遊雄誘憂融優与予余誉預幼用羊妖洋要容庸揚揺葉陽溶腰様瘍踊窯養擁謡曜抑沃浴欲翌翼拉裸羅来雷頼絡落酪辣乱卵覧濫藍欄吏利里理痢裏履璃離陸立律慄略柳流留竜粒隆硫侶旅虜慮了両良料涼猟陵量僚領寮療瞭糧力緑林厘倫輪隣臨瑠涙累塁類令礼冷励戻例鈴零霊隷齢麗暦歴列劣烈裂恋連廉練錬呂炉賂路露老労弄郎朗浪廊楼漏籠六録麓論和話賄脇惑枠湾腕]|愛しい|愛でる|哀し|悪し|圧す|以て|威す|為[さしすせそらりるれろ]|依[らりるれろ]|遺す|逸[らりるれろ]|印[さしすせそ]|益々|悦[ばびぶべぼ]|往[かきくけこ]|憶え|温い|禍々|画く|化[わえ]|何れ|害う|概ね|解[らりるれろ]|較べ|覚る|括[らりるれろ]|活[かきけ]|喚く|喚[かきくけこ]|看[るれろてな]|観[たてるれろ]|観な[いかけ]|還[さしすせそ]|希[^\u4E00-\u9FFF]|棄て|宜し|起つ|企[まみむめも]|旧い|急[かく]|空し|虚し|恐[いが]|屈[まみむめも]|係わ|顕れ|厳つ|紅い|司る|自ず|旨い|失せ|赦[さしすせそ]|[^\u4E00-\u9FFF]射[さしすせそ]|充[たち]|称え|浸[みか]|選り|想[いうえおわ]|即ち|貯え|直ぐ|墜ち|点[きくけこ]|点[かな]凍て|盗[らりるれろ]|難い|別け|報せ|未だ|密か|優る|易[いく]




2011年10月16日日曜日

翻訳者と校正者のための正規表現 (15) - 小学校学年別漢字の検出

むしゃくしゃしていないけど、応用サンプルとして作成してみた。ぎっくり腰で仕事断っているから結構暇なんです。

.NET ベースの正規表現エンジン向けです。学年ごとに色分けしています (上から小学一年生~小学六年生)。

たとえば、小学四年生向けの文章をチェックするときは、小学三年生までの漢字範囲 (「一」~「和」) を使用し、残りを削除して適用すれば、習得済み以外の漢字を検出します。


[一-龠-[一右雨円王音下火花貝学気九休玉金空月犬見五口校左三山子四糸字耳七車手十出女小上森人水正生青夕石赤千川先早草足村大男竹中虫町天田土二日入年白八百文木本名目立力林六引羽雲園遠何科夏家歌画回会海絵外角楽活間丸岩顔汽記帰弓牛魚京強教近兄形計元言原戸古午後語工公広交光考行高黄合谷国黒今才細作算止市矢姉思紙寺自時室社弱首秋週春書少場色食心新親図数西声星晴切雪船線前組走多太体台地池知茶昼長鳥朝直通弟店点電刀冬当東答頭同道読内南肉馬売買麦半番父風分聞米歩母方北毎妹万明鳴毛門夜野友用曜来里理話悪安暗医委意育員院飲運泳駅央横屋温化荷開界階寒感漢館岸起期客究急級宮球去橋業曲局銀区苦具君係軽血決研県庫湖向幸港号根祭皿仕死使始指歯詩次事持式実写者主守取酒受州拾終習集住重宿所暑助昭消商章勝乗植申身神真深進世整昔全相送想息速族他打対待代第題炭短談着注柱丁帳調追定庭笛鉄転都度投豆島湯登等動童農波配倍箱畑発反坂板皮悲美鼻筆氷表秒病品負部服福物平返勉放味命面問役薬由油有遊予羊洋葉陽様落流旅両緑礼列練路和愛案以衣位囲胃印英栄塩億加果貨課芽改械害各覚街完官管関観願希季紀喜旗器機議求泣救給挙漁共協鏡競極訓軍郡径型景芸欠結建健験固功好候航康告差菜最材昨札刷殺察参産散残士氏史司試児治辞失借種周祝順初松笑唱焼象照賞臣信成省清静席積折節説浅戦選然争倉巣束側続卒孫帯隊達単置仲貯兆腸低底停的典伝徒努灯堂働特得毒熱念敗梅博飯飛費必票標不夫付府副粉兵別辺変便包法望牧末満未脈民無約勇要養浴利陸良料量輪類令冷例歴連老労録圧移因永営衛易益液演応往桜恩可仮価河過快賀解格確額刊幹慣眼基寄規技義逆久旧居許境均禁句群経潔件券険検限現減故個護効厚耕鉱構興講混査再災妻採際在財罪雑酸賛支志枝師資飼示似識質舎謝授修述術準序招承証条状常情織職制性政勢精製税責績接設舌絶銭祖素総造像増則測属率損退貸態団断築張提程適敵統銅導徳独任燃能破犯判版比肥非備俵評貧布婦富武復複仏編弁保墓報豊防貿暴務夢迷綿輸余預容略留領異遺域宇映延沿我灰拡革閣割株干巻看簡危机貴揮疑吸供胸郷勤筋系敬警劇激穴絹権憲源厳己呼誤后孝皇紅降鋼刻穀骨困砂座済裁策冊蚕至私姿視詞誌磁射捨尺若樹収宗就衆従縦縮熟純処署諸除将傷障城蒸針仁垂推寸盛聖誠宣専泉洗染善奏窓創装層操蔵臓存尊宅担探誕段暖値宙忠著庁頂潮賃痛展討党糖届難乳認納脳派拝背肺俳班晩否批秘腹奮並陛閉片補暮宝訪亡忘棒枚幕密盟模訳郵優幼欲翌乱卵覧裏律臨朗論]]


IT 系の翻訳にはあまり使えないけど、教育関係の翻訳や校正を担当している人には役立つかも。でも、そういう人達は既に便利な方法を考えているんだろうなめくじズリズリ。

2010年12月2日木曜日

翻訳者と校正者のための正規表現 (14) - JIS第1水準以外の漢字の検出

えーと。

ムシャクシャしてやった
どの正規表現でも良かった
今は反省している

次にJIS第1水準漢字以外の漢字を検出する正規表現を示します。なぜこんなことになったか・・・それはUnicodeにとってJISの水準なんか知ったこっちゃないから、あちこちに散らばってるんです。こうやって全指定する方法しか考えつきませんでしたw

[一-龠-[亜唖娃阿哀愛挨姶逢葵茜穐悪握渥旭葦芦鯵梓圧斡扱宛姐虻飴絢綾鮎或粟袷安庵按暗案闇鞍杏以伊位依偉囲夷委威尉惟意慰易椅為畏異移維緯胃萎衣謂違遺医井亥域育郁磯一壱溢逸稲茨芋鰯允印咽員因姻引飲淫胤蔭院陰隠韻吋右宇烏羽迂雨卯鵜窺丑碓臼渦嘘唄欝蔚鰻姥厩浦瓜閏噂云運雲荏餌叡営嬰影映曳栄永泳洩瑛盈穎頴英衛詠鋭液疫益駅悦謁越閲榎厭円園堰奄宴延怨掩援沿演炎焔煙燕猿縁艶苑薗遠鉛鴛塩於汚甥凹央奥往応押旺横欧殴王翁襖鴬鴎黄岡沖荻億屋憶臆桶牡乙俺卸恩温穏音下化仮何伽価佳加可嘉夏嫁家寡科暇果架歌河火珂禍禾稼箇花苛茄荷華菓蝦課嘩貨迦過霞蚊俄峨我牙画臥芽蛾賀雅餓駕介会解回塊壊廻快怪悔恢懐戒拐改魁晦械海灰界皆絵芥蟹開階貝凱劾外咳害崖慨概涯碍蓋街該鎧骸浬馨蛙垣柿蛎鈎劃嚇各廓拡撹格核殻獲確穫覚角赫較郭閣隔革学岳楽額顎掛笠樫橿梶鰍潟割喝恰括活渇滑葛褐轄且鰹叶椛樺鞄株兜竃蒲釜鎌噛鴨栢茅萱粥刈苅瓦乾侃冠寒刊勘勧巻喚堪姦完官寛干幹患感慣憾換敢柑桓棺款歓汗漢澗潅環甘監看竿管簡緩缶翰肝艦莞観諌貫還鑑間閑関陥韓館舘丸含岸巌玩癌眼岩翫贋雁頑顔願企伎危喜器基奇嬉寄岐希幾忌揮机旗既期棋棄機帰毅気汽畿祈季稀紀徽規記貴起軌輝飢騎鬼亀偽儀妓宜戯技擬欺犠疑祇義蟻誼議掬菊鞠吉吃喫桔橘詰砧杵黍却客脚虐逆丘久仇休及吸宮弓急救朽求汲泣灸球究窮笈級糾給旧牛去居巨拒拠挙渠虚許距鋸漁禦魚亨享京供侠僑兇競共凶協匡卿叫喬境峡強彊怯恐恭挟教橋況狂狭矯胸脅興蕎郷鏡響饗驚仰凝尭暁業局曲極玉桐粁僅勤均巾錦斤欣欽琴禁禽筋緊芹菌衿襟謹近金吟銀九倶句区狗玖矩苦躯駆駈駒具愚虞喰空偶寓遇隅串櫛釧屑屈掘窟沓靴轡窪熊隈粂栗繰桑鍬勲君薫訓群軍郡卦袈祁係傾刑兄啓圭珪型契形径恵慶慧憩掲携敬景桂渓畦稽系経継繋罫茎荊蛍計詣警軽頚鶏芸迎鯨劇戟撃激隙桁傑欠決潔穴結血訣月件倹倦健兼券剣喧圏堅嫌建憲懸拳捲検権牽犬献研硯絹県肩見謙賢軒遣鍵険顕験鹸元原厳幻弦減源玄現絃舷言諺限乎個古呼固姑孤己庫弧戸故枯湖狐糊袴股胡菰虎誇跨鈷雇顧鼓五互伍午呉吾娯後御悟梧檎瑚碁語誤護醐乞鯉交佼侯候倖光公功効勾厚口向后喉坑垢好孔孝宏工巧巷幸広庚康弘恒慌抗拘控攻昂晃更杭校梗構江洪浩港溝甲皇硬稿糠紅紘絞綱耕考肯肱腔膏航荒行衡講貢購郊酵鉱砿鋼閤降項香高鴻剛劫号合壕拷濠豪轟麹克刻告国穀酷鵠黒獄漉腰甑忽惚骨狛込此頃今困坤墾婚恨懇昏昆根梱混痕紺艮魂些佐叉唆嵯左差査沙瑳砂詐鎖裟坐座挫債催再最哉塞妻宰彩才採栽歳済災采犀砕砦祭斎細菜裁載際剤在材罪財冴坂阪堺榊肴咲崎埼碕鷺作削咋搾昨朔柵窄策索錯桜鮭笹匙冊刷察拶撮擦札殺薩雑皐鯖捌錆鮫皿晒三傘参山惨撒散桟燦珊産算纂蚕讃賛酸餐斬暫残仕仔伺使刺司史嗣四士始姉姿子屍市師志思指支孜斯施旨枝止死氏獅祉私糸紙紫肢脂至視詞詩試誌諮資賜雌飼歯事似侍児字寺慈持時次滋治爾璽痔磁示而耳自蒔辞汐鹿式識鴫竺軸宍雫七叱執失嫉室悉湿漆疾質実蔀篠偲柴芝屡蕊縞舎写射捨赦斜煮社紗者謝車遮蛇邪借勺尺杓灼爵酌釈錫若寂弱惹主取守手朱殊狩珠種腫趣酒首儒受呪寿授樹綬需囚収周宗就州修愁拾洲秀秋終繍習臭舟蒐衆襲讐蹴輯週酋酬集醜什住充十従戎柔汁渋獣縦重銃叔夙宿淑祝縮粛塾熟出術述俊峻春瞬竣舜駿准循旬楯殉淳準潤盾純巡遵醇順処初所暑曙渚庶緒署書薯藷諸助叙女序徐恕鋤除傷償勝匠升召哨商唱嘗奨妾娼宵将小少尚庄床廠彰承抄招掌捷昇昌昭晶松梢樟樵沼消渉湘焼焦照症省硝礁祥称章笑粧紹肖菖蒋蕉衝裳訟証詔詳象賞醤鉦鍾鐘障鞘上丈丞乗冗剰城場壌嬢常情擾条杖浄状畳穣蒸譲醸錠嘱埴飾拭植殖燭織職色触食蝕辱尻伸信侵唇娠寝審心慎振新晋森榛浸深申疹真神秦紳臣芯薪親診身辛進針震人仁刃塵壬尋甚尽腎訊迅陣靭笥諏須酢図厨逗吹垂帥推水炊睡粋翠衰遂酔錐錘随瑞髄崇嵩数枢趨雛据杉椙菅頗雀裾澄摺寸世瀬畝是凄制勢姓征性成政整星晴棲栖正清牲生盛精聖声製西誠誓請逝醒青静斉税脆隻席惜戚斥昔析石積籍績脊責赤跡蹟碩切拙接摂折設窃節説雪絶舌蝉仙先千占宣専尖川戦扇撰栓栴泉浅洗染潜煎煽旋穿箭線繊羨腺舛船薦詮賎践選遷銭銑閃鮮前善漸然全禅繕膳糎噌塑岨措曾曽楚狙疏疎礎祖租粗素組蘇訴阻遡鼠僧創双叢倉喪壮奏爽宋層匝惣想捜掃挿掻操早曹巣槍槽漕燥争痩相窓糟総綜聡草荘葬蒼藻装走送遭鎗霜騒像増憎臓蔵贈造促側則即息捉束測足速俗属賊族続卒袖其揃存孫尊損村遜他多太汰詑唾堕妥惰打柁舵楕陀駄騨体堆対耐岱帯待怠態戴替泰滞胎腿苔袋貸退逮隊黛鯛代台大第醍題鷹滝瀧卓啄宅托択拓沢濯琢託鐸濁諾茸凧蛸只叩但達辰奪脱巽竪辿棚谷狸鱈樽誰丹単嘆坦担探旦歎淡湛炭短端箪綻耽胆蛋誕鍛団壇弾断暖檀段男談値知地弛恥智池痴稚置致蜘遅馳築畜竹筑蓄逐秩窒茶嫡着中仲宙忠抽昼柱注虫衷註酎鋳駐樗瀦猪苧著貯丁兆凋喋寵帖帳庁弔張彫徴懲挑暢朝潮牒町眺聴脹腸蝶調諜超跳銚長頂鳥勅捗直朕沈珍賃鎮陳津墜椎槌追鎚痛通塚栂掴槻佃漬柘辻蔦綴鍔椿潰坪壷嬬紬爪吊釣鶴亭低停偵剃貞呈堤定帝底庭廷弟悌抵挺提梯汀碇禎程締艇訂諦蹄逓邸鄭釘鼎泥摘擢敵滴的笛適鏑溺哲徹撤轍迭鉄典填天展店添纏甜貼転顛点伝殿澱田電兎吐堵塗妬屠徒斗杜渡登菟賭途都鍍砥砺努度土奴怒倒党冬凍刀唐塔塘套宕島嶋悼投搭東桃梼棟盗淘湯涛灯燈当痘祷等答筒糖統到董蕩藤討謄豆踏逃透鐙陶頭騰闘働動同堂導憧撞洞瞳童胴萄道銅峠鴇匿得徳涜特督禿篤毒独読栃橡凸突椴届鳶苫寅酉瀞噸屯惇敦沌豚遁頓呑曇鈍奈那内乍凪薙謎灘捺鍋楢馴縄畷南楠軟難汝二尼弐迩匂賑肉虹廿日乳入如尿韮任妊忍認濡禰祢寧葱猫熱年念捻撚燃粘乃廼之埜嚢悩濃納能脳膿農覗蚤巴把播覇杷波派琶破婆罵芭馬俳廃拝排敗杯盃牌背肺輩配倍培媒梅楳煤狽買売賠陪這蝿秤矧萩伯剥博拍柏泊白箔粕舶薄迫曝漠爆縛莫駁麦函箱硲箸肇筈櫨幡肌畑畠八鉢溌発醗髪伐罰抜筏閥鳩噺塙蛤隼伴判半反叛帆搬斑板氾汎版犯班畔繁般藩販範釆煩頒飯挽晩番盤磐蕃蛮匪卑否妃庇彼悲扉批披斐比泌疲皮碑秘緋罷肥被誹費避非飛樋簸備尾微枇毘琵眉美鼻柊稗匹疋髭彦膝菱肘弼必畢筆逼桧姫媛紐百謬俵彪標氷漂瓢票表評豹廟描病秒苗錨鋲蒜蛭鰭品彬斌浜瀕貧賓頻敏瓶不付埠夫婦富冨布府怖扶敷斧普浮父符腐膚芙譜負賦赴阜附侮撫武舞葡蕪部封楓風葺蕗伏副復幅服福腹複覆淵弗払沸仏物鮒分吻噴墳憤扮焚奮粉糞紛雰文聞丙併兵塀幣平弊柄並蔽閉陛米頁僻壁癖碧別瞥蔑箆偏変片篇編辺返遍便勉娩弁鞭保舗鋪圃捕歩甫補輔穂募墓慕戊暮母簿菩倣俸包呆報奉宝峰峯崩庖抱捧放方朋法泡烹砲縫胞芳萌蓬蜂褒訪豊邦鋒飽鳳鵬乏亡傍剖坊妨帽忘忙房暴望某棒冒紡肪膨謀貌貿鉾防吠頬北僕卜墨撲朴牧睦穆釦勃没殆堀幌奔本翻凡盆摩磨魔麻埋妹昧枚毎哩槙幕膜枕鮪柾鱒桝亦俣又抹末沫迄侭繭麿万慢満漫蔓味未魅巳箕岬密蜜湊蓑稔脈妙粍民眠務夢無牟矛霧鵡椋婿娘冥名命明盟迷銘鳴姪牝滅免棉綿緬面麺摸模茂妄孟毛猛盲網耗蒙儲木黙目杢勿餅尤戻籾貰問悶紋門匁也冶夜爺耶野弥矢厄役約薬訳躍靖柳薮鑓愉愈油癒諭輸唯佑優勇友宥幽悠憂揖有柚湧涌猶猷由祐裕誘遊邑郵雄融夕予余与誉輿預傭幼妖容庸揚揺擁曜楊様洋溶熔用窯羊耀葉蓉要謡踊遥陽養慾抑欲沃浴翌翼淀羅螺裸来莱頼雷洛絡落酪乱卵嵐欄濫藍蘭覧利吏履李梨理璃痢裏裡里離陸律率立葎掠略劉流溜琉留硫粒隆竜龍侶慮旅虜了亮僚両凌寮料梁涼猟療瞭稜糧良諒遼量陵領力緑倫厘林淋燐琳臨輪隣鱗麟瑠塁涙累類令伶例冷励嶺怜玲礼苓鈴隷零霊麗齢暦歴列劣烈裂廉恋憐漣煉簾練聯蓮連錬呂魯櫓炉賂路露労婁廊弄朗楼榔浪漏牢狼篭老聾蝋郎六麓禄肋録論倭和話歪賄脇惑枠鷲亙亘鰐詫藁蕨椀湾碗腕]]

「なげーよ」と言ったそこのあなた。いい方法があったら教えてくださいよ。ちなみに .Net Framework の正規表現エンジンを使用しているソフトでは、ちゃんと動作しますよ。文字長で弾かれると思いましたが Trados でも動作しました。正規表現の代入先変数は余裕があるんですね・・・。

だれか正規表現の仕事くれないかなぁ。そうだ、このブログのデータを使用できるのは、フリーランスの皆様、および私に単価の高い仕事くれたエージェントのみということにしよう。フリーランスの方はご自由に。エージェントが社内で使用するときは私に仕事をw 名づけて「バナナライセンス」。


outsideofjis1

使用できるとはいえ、私も少し嫌なので、他に方法がないか考えてみますねこ飼いたい。

2010年11月9日火曜日

翻訳者と校正者のための正規表現 (13) - 「り」と「リ」、「カ」と「力」

小さなことなんですが、最近作業した案件の翻訳メモリの中に「り」を使用するべき場所に「リ」を間違えて使用しているセグメントがあったので、久しぶりに正規表現を書いてみました。

フォントの種類と大きさ次第では、まぁ確かに見分けにくいんですが・・・よくもまぁ校正をパスしたなぁ。正規表現は簡単です。

\P{IsKatakana}リ\P{IsKatakana}

ここでのアイデアは、「『リ』が正しく使用されている場合は、左右どちらかにカタカナが続く必要がある」ということです。つまり両方共カタカナでない箇所を検出すればいいのです。

それほど見分けにくいものではないのに、なぜこんなことが起きるのか正直不思議です。確認せずに一括置換したか、日本語入力システムを持たない海外のエージェントが似ている字形をコピペしたのかなぁ。

すべてのカタカナの 1 文字孤立を検出する正規表現は次のようになります。

[\P{IsKatakana}^]\p{IsKatakana}[\P{IsKatakana}$]

ここで「^」は角かっこの直後にはないので文頭を表します。また、「$」は文末を表します。日本語で説明すると、「カタカナ 1 文字の左側が非カタカナか文頭、かつ右側が非カタカナか文末である」になります。

実際に適用してみましょう。

katakana


もっと見分けにくいものに、カタカナの「カ」と漢字の「力 (ちから)」があります。この間違いには出会ったことがありません。標準的なフォントでは、校正者も読者もほぼ区別できませんが、最終原稿のフォント次第では、ひどく目立つかもしれません。

カラス (カタカナ)
力ラス (ちから)

人生で出会うことは、ほぼないと思いますw。「カ (カタカナ)」の不適切な使用は上の表現で検出できますが、「力 (ちから)」の不適切な使用を検出したいと思う方は、正規表現の勉強も兼ねて色々と試行錯誤してみてください。私も暇なときに考えておきます (なんて奴だw)。

100% 正確に検出できる正規表現ではなく、正しい用法が少しヒットしても構わないと考える必要があると思いマッスル。

2010年10月11日月曜日

翻訳者と校正者のための正規表現 (12) - 空白検出のベース

前回は、正規表現を構築する際に最初に設定するべき正規表現を書きました。次に設定するのはスペースの検出でしょう。

以前から、正規表現の基本の説明に絡めて、スペース (正確には空白文字) の検出をしてきましたが、実務でベースとして使用する場合に適切と思われる正規表現を次に示します (折り返されていますが 1 行の表現です)。

(\p{IsCJKUnifiedIdeographs}|\p{IsHiragana}|\p{IsKatakana}|\p{IsCJKSymbolsandPunctuation})\s+(\p{IsCJKUnifiedIdeographs}|\p{IsHiragana}|\p{IsKatakana}|\p{IsCJKSymbolsandPunctuation})

はい、これで漢字、ひらがな、カタカナ、句読点の間の不要なスペースをすべて検出できます。IsBasicLatin が含まれていないのは、もちろん英数文字間や英数字と和文の空白を許容するためです。.NET 系以外のソフトウェァでは、[ぁーん] や文字コードに置き換える必要があります。


カタカナ間のスペースを許容する場合 (ダイアログ ボックスなど) は、上記から IsKatakana を取り去り、Terminology Verifier などの英和ペア方式の検出に任せます。カタカナの部分が少しなら、検出されるままにして自分の目で確認するのもよいでしょう。

前回の (11) の表現とこの (12) の表現は、広いジャンルでベースとして使用できると思います。あとは、クライアントさんごとに工夫していくだけです。

そろそろ書くことがなくなってきました。正規表現エンジンがいくつかあるので混乱しやすいのですが、覚えることは結構少なくて、あとは応用です。

とりあえず、今までの記事をまとめたページを近々作成しようと考えています。次回以降の記事は未定です。何か思いついたら書いてみたいと思います。「これを検出したい」というコメントをいただけたら、できるだけ回答していきたいと思います。

(・∀・)シゴトクレ♪ ヒマダ♪シャンティ♪*・゜゚・*:.。. .。.:*・゜゚・*

2010年10月5日火曜日

翻訳者と校正者のための正規表現 (11) - 常識的な文字以外の検出

いい加減、すぐに使用できる実用的なものを提示しないと、投稿末尾のダジャレしか読んでくれなくなりそうですw

今回は、以下の .NET 表現を使用します。なので TagEditor とかの .NET ベース向けです。

  • IsBasicLatin (基本ラテン文字)
  • IsCJKUnifiedIdeographs (CJK 統合表意文字 (漢字))
  • IsHiragana (ひらがな)
  • IsKatakana (カタカナ)
  • IsCJKSymbolsandPunctuation (CJK 句読点)
この 5 つで、日本語の文章はほとんどカバーされます。というわけで、これらをクラスにまとめて否定形を作成すればよいのです。


[^\p{IsBasicLatin}\p{IsCJKUnifiedIdeographs}\p{IsHiragana}\p{IsKatakana}\p{IsCJKSymbolsandPunctuation}]

これで作業しても良いのですが、IsHalfwidthandFullwidthForms (半角カタカナ全角英数記号) が含まれていないので、割とよく許容される全角丸括弧がありません。なので文字クラスに加えてみます。他にも許容できる文字があったら、任意に加えていきます。


[^\p{IsBasicLatin}\p{IsCJKUnifiedIdeographs}\p{IsHiragana}\p{IsKatakana}\p{IsCJKSymbolsandPunctuation}()]

これで、常識的な文字以外はすべて検出されるはずです。Wikipedia の文章で試してみましょう (末尾に通常使用しない文字を追加しています)。


はい、無事に「通常使用しない文字」だけ検出されました。

英日の翻訳であれば、これをベースに改造するなり、別の正規表現を追加するなりして発展させるとよいでしょう。日本語以外への翻訳者は MSDN や Wiktionary で文字範囲を確認して工夫してください。

これからは、実用的なものをポツポツ書いていくつもりですこんぶうま。

2010年10月3日日曜日

翻訳者と校正者のための正規表現 (10) - 文字列の引き算

]  ミ(ノ ̄^ ̄)ノスチャッ!(o_ _)oドテッ(o― ―)oムクッ.......(o ̄ii ̄)ゞハナヂブー

いや、面白い AA をいただいたのでついw
今回は引き算です。数学の時間ではありません。文字の引き算です。

以前の投稿で、文字範囲を指定して記述する方法について書きましたが、その範囲内に 1 つだけ検出したくない文字が含まれていたら嫌ですよね。

[a-z] の範囲で g だけ外したいときに、[a-fh-z] とかにするのもありです。でも、飛び飛びで複数個あったら面倒ですよね。そんなときに、次のような正規表現を使用できます。

[a-z-[ikw]]

[ ] の中に -[ ] を書くと引き算になります。上の表現は、[a-z] の範囲から [ikw] の文字クラスを除外するという意味になります。ちょっと試してみましょう。


うむ、kiwi が消えましたね。でもこの表現は、反キウイフルーツ革命市民団体全国連絡会議しか使用できません。どんな場面に実用的でしょうか。

前に、.NET 系で使用できる IsHalfwidthandFullwidthForms (半角カタカナ、全角英数記号などを検出) を紹介しました。含まれる文字は
Unicord.org のこの PDF  
を参照してください。ほとんどの場合、そのまま使用できます。だって普通は使用しない文字ですから。

ところが、これには全角括弧類も含まれているんです。お客様の大半は、半角カタカナと全角英数記号を禁止しているんですが、かなりの数のクライアントさんが
「後生ですから丸括弧は、丸括弧だけは全角にしてあげたいんです。返済はもう少し待っていただけませんか (T^T)」と懇願します。

そういう場合に、次の表現を使用できます。


[\p{IsHalfwidthandFullwidthForms}-[()]]
文字コードの場合は
[\uFF00-\uFFEF-[()]]

これは半角カタカナと全角英数記号を検出しながら、全角丸括弧だけは例外という正規表現になります。実際にやってみましょう。


全角丸括弧にはヒットしませんでしたね。正規表現の引き算は、例外の作成に適しています。それではこの辺たいじゃないよ、変態という名の紳士だよ!

2010年10月2日土曜日

翻訳便利ツール (3) - 正規表現チェッカー

あーもー、1 日に何度も更新してごめんなさい。これ、「・・・のための正規表現」シリーズにしようかなと思ったんですけど、ちょっとちがうなと。どちらかというと、ツール扱いではないかと。

えーっと、CAT ツールで正規表現を組むときにイラつくことがあります。えぇ、間違った正規表現を登録してしまった時です。登録時点では、テストできないのです。

まずい正規表現を入れてしまったら、また数回クリックして、ダイアログ開いて、登録し直して、再度チェックするという作業になります。えらいめんどくさいんですよ、これが。

目的の正規表現を、登録前にテストできたらいいですよね。

-----

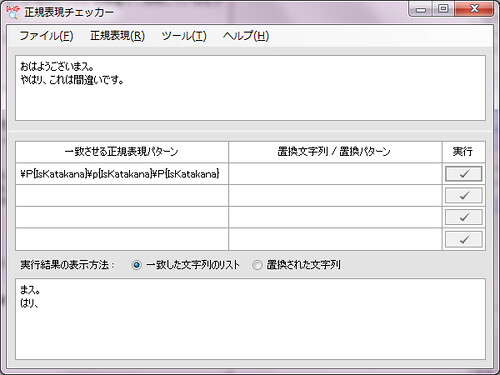
SDL Trados TagEditor の正規表現エンジン部分は .NET Framework ライブラリを使用しているようなので、.NET Framework で作成された正規表現チェッカーが必要です。そこで Asterworld さん開発のフリーソフト「正規表現チェッカー (vector へのリンク)」ですよ・・・名前がストレートすぎて男を感じます。Free と Share のモードがありますが、Free で全然問題ないです。


一番上の窓に、対象となる文章を張り付けて、二段目に正規表現を書いて [実行] ボタンをぽちりとおすと、一致した文字列のリストが三段目に表示されます。この例では、見えないけどスペースにもヒットしていることに注意してください。もちろん文字コードも \u0000 のパターンで指定できます。

元となるライブラリが同じはずなので、これでチェックしてから TagEditor の QA Checker に登録すると、余計な手間が必要ありません。正直 QA Checker 上で試行錯誤なんてできません。

この情報で、皆様の翻訳肉体労働が軽減されるといいですネモ船長。

翻訳者と校正者のための正規表現 (9) - 正規表現の種類など

いままで [ぁ-ん] とか正規表現で喘ぎ声をあげてきたわけですが、コードや名前ブロックを知っているとカッコよく記述できたりします。

ですが、そのエディタが、どの正規表現エンジンを使用しているか、どの開発言語を使用しているかで使用できる表現が異なります。なんとなく知っているだけで、以下の種類があります。

POSIX 系
AWK 系
Pearl 系
独自実装系

Web で見つけた「おおっ!」という正規表現が、自分のエディタでは使用できなくて (´・ω・`)ショボーン したりしますが、これらが一因となっていると思います。開発言語や、何に準拠しているかを公表していないエディタだと、いろいろ試してみるしかありません。逆に、何に準拠しているかが判明したら、今までできなかった表現ができるかもしれません。

-----

ところで、Microsoft 社の .NET Framework で開発されたエディタでは、文字コードの範囲ごとに名前が付けられています。「サポートされている名前付きブロック」 (MSDN リンク) を参照してください。

.NET Framework を利用した正規表現プログラムであれば、文字を記述する代わりに、これらの表現を使用できるはずです。

SDL Trados のサポートの人も知らないかもしれませんが、Trados TagEditor の正規表現エンジンでは .NET Framework の「名前付きブロック」を使用できます。ライブラリをパクっただけ、もとい有効活用したのでしょうね。下記のような表現が使用できます。

\p{IsBasicLatin}

これは、すべての基本ラテン文字 (pdf リンク) を検出する記述です。\p は右の名前ブロックに含まれる文字列を検出するという意味です。P を大文字にして \P とすると、右の名前ブロックに含まれない文字列を検出します。英訳が多く、訳文に半角英数記号しか許されない人には、下記の表現が便利かもしれませんね。

\P{IsBasicLatin}

TagEditor の QA Checker 内で、IsBasicLatin の範囲を、あえて文字コードで書く場合は次のようになります。

[\u0000-\u007F]

いくつかのエディタ (VxEditor など) では、次のように「x」を使用して記述する必要があります。ちなみに、VxEditor では、AWK 互換と Pearl 互換の正規表現エンジンから選択できます。

[\x0000-\x007F]

まぁ、[ぁ-ん] とかの実体記述の方が後でわかりやすくて便利という見方もありますね。

-----

最後に、.NET 系列で使用できる文字ブロックをいくつか挙げておきます。

IsHiragana
ひらがな全部

IsKatakana
カタカナ全部

IsHalfwidthandFullwidthForms
半角カタカナ、全角英数などのマイノリティ~

IsEnclosedCJKLettersandMonths
①、㈱ などの括弧や丸で囲まれた文字

他にも便利なものがありますので、さっきの MSDN のリンクで調べてみてください。

-----

今日はこんな感じで終わりますよっちゃんて言えば「イカ」! 「野村」ではない。

2010年9月30日木曜日

翻訳者と校正者のための正規表現 (8) - 助詞の連続

今回は助詞の連続による違和感の検出について書いてみたいと思います。まずは、下記の例文をご覧ください。

右上のアドレス ペインの下の [検索] をクリックします。

私だったら次のように修正します。

右上のアドレス ペインの下にある [検索] をクリックします。

次のように修正する人もいると思います。

右上にアドレス ペインがあります。その下の [検索] をクリックします。


違和感を感じる方も感じない方もいると思います。「の」の 3 個連続は違和感のぎりぎりの線だと思います。まぁ、表現に正解などありませんが、私が違和感を感じるのでしょうがないですw。というわけで、極端な例をWikipedia に限定して検出 (Google 検索) してみました。

しかし、退去命令の再度の申立ての場合は、被害者の転居の時間の確保のための制度という点から・・・

むむむ。法律関係だからこのような言い回しになるのかよくわかりませんが、私はこう直してしまうと思います。

しかし、退去命令の申立てが再度行われた場合、この制度が被害者の転居時間の確保を目的としていることをかんがみて・・・

というわけで、次の表現で、「の」の 4 連続以上を検出できます。

(の.{0,5}){4,}

言葉で表現すると「『の』の次に 0 ~ 5 個の任意の文字があるパターンが 4 回以上連続している」になります。繰り返し数は、自分の許容度で決めてもよいと思います。


ついでに「を」の連続も見てみましょうか。Wikipedia に限定して「を」の 3 連続を検出してみました。問題のある部分を太字にしています。わかりにくい文章、というかどう考えても修正忘れだと思いますが。

茎から切り取った花を切り花というが、これを花を方向をそろえて束ねたものを花束(ブーケ)、組み合わせて輪にした花輪などもさまざまなものが見られ、

ナビ人: 人間をお世話をなどをするメイドナビと呼ばれるサイボーグ。

自分だったら、それぞれこう修正します。

茎から切り取った花を切り花と呼ぶが、これらの花の方向をそろえて束ねた花束(ブーケ)、組み合わせて輪にした花輪など、さまざまな種類があり、

ナビ人: 人間の世話などをする、メイドナビと呼ばれるサイボーグ。

もう正規表現は作成できますね。

--
もちろん検出しても許容できる場合がありますよ。
「ぜんまいの のの字ばかりの 寂光土」 -- 川端茅舎
--

2010年9月27日月曜日

翻訳者と校正者のための正規表現 (7) - ひらがなの連続など

ここまでブログを読んでいただいた方は、「なんか単純なスタイル規則の検出だけだなぁ」と感じているかもしれません。しかし、経験から言うと、こういう単純なスタイル エラーが一番多いのです。翻訳者だけでなく、エディタ、プルーフリーダ、最終クライアントまで見逃します。

仕様書を正規表現化して、その会社のローカライズされた Web サイトをチェックしてみましょう。パブリッシングまでの各レベルで厳格な管理を行っていないプロジェクトだと、最終品で複数個のエラーが見つかります。ここまで見逃されるとスタイルの意味があるのかってことですが・・・、規則ですからしょうがありません。ソース クライアントさんの最終チェックでスタイル違反が生み出されることもよくあります。


まぁ、こういう明確なスタイルは、検出が簡単ですからいいとして、日本語表現のエラーを検出しようとすると、大型案件を処理する PM (兼エディタ) さんの立場が必要です。どのようなエラーが多いかを見極めて対処しなくてはなりません。すべての文法エラーを正規表現化できる人なんていません。いたら、その正規表現のセットを数十億円で買い取る企業が出てくるでしょう。

ただ「ほとんどの場合間違い」または「ほとんどの場合改良の余地あり」というものを検出するアイデアがいくつかあります。以下に例を示します。


ひらがなの連続 → [ぁ-ん]{7,} とか [ぁ-ん]{9,} とか
PM 作業をしていたときの経験ですが、技術文書でひらがなが連続する場合は、冗長な言い回しの可能性があります。ジャンルや、常体か敬体かで異なりますが、7 ~ 8 文字以上は要注意です。少なくとも、なぜひらがなが連続しているのかの確認ぐらいはしてもよいでしょう。Web 上の文章で試してみると、いろいろな発見があると思います。

下記は Wikipedia からの引用で、ひらがなが 7 文字以上連続している部分を赤で示しています。ひらがなの連続を抑えてみました。また、マニュアルで一般的な敬体へと変更しています。

[原文]
例えば、虹の色の数は、日本では七色とされているが、他の地域や文化によっては七色とは限らない。また、日本語で「青」と呼ばれるものに緑色の植物や信号灯が含まれるのも、単純に単語を置き換えることができない顕著な例である。このような一対一対応がないという問題は、機械翻訳の実現が単なる単語の差し替えでは不十分であることにもつながっている。

[技術 (マニュアル) 系へとリライトしてみた]
たとえば、日本で虹の色の数が七色でも、他の国や文化でも同じとは限りません。さらに、日本語では、緑色の植物や信号灯を「青」と呼ぶなどの例もあり、単語を一対一で置き換えるだけでは、実用的な機械翻訳システムは構築できません。

えらそうにリライトしてごめんなさい m(_ _)m。原文がダメという意味ではなく、自分が技術系 (特に IT マニュアル) 文書のエディタだったらこうする、というだけです (そんな資格も技量もないけどねw)。Wikipedia 上の文章としては原文で全然 OK だと思います。まあ、ライティングだからここまで自由に変更できたのですが、翻訳の場合は「いろいろな縛り」があるので、きついですよね。

技術系の翻訳やライティングの第一目的は「単純明快簡潔至極」であることです。特に「~することができます」や「~というようなことがあります」はローカライズ業界で嫌われていると思います。知っているだけで、ソース クライアント数社が使用禁止または非推奨としています。ひらがなの連続を検出すると、これらの冗長な表現がよく見つかります。

助詞修正後の削除忘れ → がを|をが|はを
えーと、意外に多いんです。これは変換確定前に既に置換されたように見えるのが原因かもしれません。態を変えたときにそのまま残るようです。このほかにも助詞のつながりが妙なパターンを見つけたら、正規表現にできないか考えてみます。

対象ジャンルでは使用することのない漢字 → 内臓|淫|性交|標示|大坂|登社
見直し中やプルーフ中に誤変換を見つけたら、同じ過ちを犯さないようにパイプで追加していきます。誤変換があるということは、ほぼすべての翻訳者の変換候補に挙がるということです。成功→性交はすごく恥ずかしいので登録をお勧めします。それと、内臓ディスクの検索結果ですが、エディタを通さない文章では、非常に多いですね。

口語とか → やっぱり|ちょっと|だったら|まずい|いんで
「やっぱり、この文書でこれはちょっとまずいんでないかい」と感じるものを見つけたら追加していきます。

---

まぁ、このブログ自体、ひらがなが連続してたり、タイポがありますが、それはほれ、あれ、えーっと、なんだっけ、PTA、NGO、いや TPO ってことで勘弁してくださいなめ猫。

2010年9月23日木曜日

翻訳者と校正者のための正規表現 (6) - 文字種の検出

さて、ここいらで実使用に耐えうる正規表現をひとつぐらい提示してみましょう。で、今日のメインは漢字の検出、半角カタカナの検出、全角英数の検出、およびそれらとスペースとの関係です! 日本語の構造エラーを見つけ出す表現もいくつかありますが、それはもう少し後にします。


この業界で長く働かれている方は、翻訳仕様書で次のような表現をよく目にするはずです。

「英数字、記号、および括弧は半角。漢字ひらがなカタカナは全角。全角と英数字半角の間は 1 スペース。ただし括弧類の内側は常にスペースなし。括弧類の外側は句読点でないかぎり 1 スペース。句読点の両側にはスペースが存在してはいけない」

これは、次のように 3 つに分けて考えます。


  1. 全角の英数字および半角カタカナを正規表現で検出
  2. 半角英数字と全角漢字ひらがなカタカナの間にスペースがないパターンを検出
  3. 括弧と句読点はそれぞれのパターンを考えて、パイプでつなげる


1 の解決:

[a-zA-Z0-9ヲ-゚]

上記は、全角アルファベットの小文字と大文字、全角数字、および半角カタカナ (ヨーグノレトなど) を検出しますw。特殊な表現で短縮していないのはわかりやすくするためです。


2 の解決:

[a-zA-Z0-9][ァ-ヶぁ-ん一-龠]|[ァ-ヶぁ-ん一-龠][a-zA-Z0-9]

なげーよw。「一-龠」は漢字の範囲を示しています。JISコードの場合は別の表現もあります。これは漢字率の算出にも応用できますね。著作権フリーの Wikipedia の CAT ツールの説明文に「一-龠」を使用してみます。

[一-龠] の実行結果
はい。漢字がすべてヒットしていることがわかると思います。つまり、2 の解決策では、半角英数と全角漢字ひらがなカタカナが、スペースなしで隣接しているものが検出されます。これでいろいろ楽しめますねw。もうちょっと工夫すれば「当用漢字以外の漢字を検出」することもできます。


3 の解決策:

\s[。、]|[。、]\s|[\(\[\"\{]\s|[^\s。、][\(\[\"\{]

左から順に日本語で説明します。
「句読点の前にスペースがあるエラー」
「句読点の後にスペースがあるエラー」
「半角括弧類の内側にスペースがあるエラー」
「半角括弧類の外側が句読点またはスペース以外であるエラー」

これらは、それなりのソフトウェアを使用すれば連続して自動で検出できます。もちろん、さらに細かく詰めることもできますが、クライアントごとに変化がありすぎるので、あとはいろいろと工夫してくだ賽の河原。

あっ、コメントは誰でも投稿できるようにしました。スパムが多すぎたら考え直すかもしれません。

2010年9月19日日曜日

翻訳者と校正者のための正規表現 (5) - 単位とスペース

こんにちは。もう 5 回目ですね。繰り返しますが、題名にあるように翻訳と校正に携わる方のための正規表現です。普通に正規表現を勉強したい方は、優れたサイトがたくさんありますので、そちらを参照していただいた方が早道かと思います。


あまり変わり映えしませんが、今回新しい要素を取り上げるために、再度「スペース」について考えてみます。「えーとね、単位の前は 1 スペースね。これ定説」というクライアントさんの場合を考えます。以前から読んでいただいている方は下記の表現がすぐに頭に浮かんだことと思います。

[^\s]MB
[^\s]GB
[^\s]TB

大正解です。でも、これらはまだブラッシュアップできます。

[^\s](MB|GB|TB)

この 1 行が上記の 3 行と同じ意味になります。ここで ( ) はグループを表します。また、パイプ | は OR の意味になります。言葉で表すと「MB または GB または TB の前にスペースがない」となります。この方が、新しい単位記号をパイプで追加していけばいいので楽ですよね。架空の文章での実際の検索結果を次に示します。


はい、無事にヒットしたようです。参考までに、次のような書き方もできます。

[^\s](k|M|G|T)(B|bps)

単位と桁数を分離しただけです。逆に使いにくくなるかもしれませんが、こういうこともできるということです。

それではこの辺にしまスーパーマリオっていうけれど普通のマリオってあったんかいな。

2010年9月18日土曜日

翻訳者と校正者のための正規表現 (4) - 桁区切り

多分「そんなの知ってるよ」と思う人がいるとは思いますが、今回も基本ですよ。基本の組み合わせです。

さて、翻訳者は数値表記のスタイルを指定されることがあります。「ソースにばらつきがあっても、3 桁ごとにカンマ入れてね。ただ西暦とか ISO 感度 3200 とかの場合はカンマ入れないでね」というものです。ソースにばらつきがある場合でも、ハンドオフ直前に正規表現置換で一括で直せるんだから、それくらいは処理してハンドオフして欲しいものです。

そこは文章肉体労働者の身分ですから、ぐっとこらえましょう (笑)。早速ですが、以下の架空の文章でエラーだけを検出するにはどうすればよいでしょうか。

「この 2010 年に発売されたカメラでは、1 回の充電で 2,200 枚程度撮影できます。フラッシュを使用した場合は、撮影可能枚数が 900 ~ 1100 枚程度になることに注意してください。また、[MENU] 画面で [自動選択 ISO 3200] を選択すると ISO 感度 3200 まで自動で調節されます。」

ここでエラーは「1100 枚」の部分だけです。いきなり正解案を提示してから解説します。

[^O度]\s[0-9]{4,}\s[^年]

そして実際に適用すると次のように、目的の部分だけにヒットします。


解説:

[0-9]{4,} → 数字が 4 個以上連続している。
\s[^年] → 連続した数字の後にスペースがあり、その後ろに「年」が存在しない。
[^O度]\s → 連続した数字の前にスペースがあり、その前に「O (オー)」も「度」も存在しない。

もちろん、これは正規表現の説明のためのものなので汎用性が低いままです。数字の前にスペースが無かったり、括弧と隣接している場合なども無視しています。なので、実際に使用して対象外の表記が引っかかった場合に、正規表現を改変したり、別の正規表現を追加したりして精度を上げていく必要があります。さまざまな表記が可能になると思います。

それではこの辺デロリアン。


2010年9月17日金曜日

翻訳者と校正者のための正規表現 (3) - スペース

長いと読む気が失せると思うので、今回から内容を半減したいと思います。

CAT ツールを使用するのであれ、テキスト エディタを使用するのであれ、スペースを視認できる形にするのがスタンダードだと思います。こういった設定をしない作業者によくあるのが次のエラーです。


折り返しされているのでわかりにくくなっていますが、りんごの後に 1 スペース残っています。通常、ひらがな間のスペースはエラーです。もっときっちりした表現もあるのですが、わかりやすい方法を使用します。

[ぁ-ん]\s+[ぁ-ん]

別に悶えているわけではありません。正規表現ではハイフンは範囲を表します。Unicode.org のひらがなテーブルでわかるように、小文字の「ぁ」から「ん」までの範囲が含まれるので、通常使用するひらがなはカバーされてしまうのです。

そして今回初登場の「+」記号は「直前の文字が 1 個以上存在する」という意味です。よって、この正規表現は「任意のひらがな間にスペースが 1 個以上存在する」になります。それでは実際にやってみましょう。


はい、正しくひらがな間のスペースが検出されました。もちろん、英数字とひらがな間のスペースは検出されません。漢字とひらがなの間のスペースはまたの機会に!

いやぁ、正規表現って本当に面白いです練馬大根。

2010年9月16日木曜日

翻訳者と校正者のための正規表現 (2) - 基本


このシリーズ、前回は正規表現の基礎の一部を紹介しました。今回も基本を続けます。

なぜかときどき見かけるのが、文頭のスペース。自動で字下げできる時代に、文頭スペースは正直邪魔になります。文書をスペースで整えるのはお勧めしません。たとえば、将来 HTML 化に取り組んだときに、スペースの不統一で余計な手間がかかります。で、文頭のスペースを検出するには、次を使用します。

^\s

「^」は文頭を表しています。その直後にスペース (空白文字) に一致する「\s」があるので、文頭のスペースに一致するわけです。ここで円 (バックスラッシュ) 文字は逆エスケープになっています。こういった記述法を略記法ともいいます。「s」は普通の文字で、これに逆エスケープを付けるとスペースを示します。全角スペースも検出する場合は、次のようになります。

^[\s ]

ちょっとわかりにくいですが「s」の後に全角スペースを入力しています。また、角かっこに注目してください。[ ] かっこはクラスを示し、これで囲まれている文字のどれでもヒットするということです。ですから、文頭にある空白文字と全角スペースにヒットします。

「^」は、左端に記述したときに文頭を示しますが、別の場所で使用すると「否定」の意味になります。たとえば、数値と単位の間を 1 スペース指定しているクライアントさんがいるとします (50 MB など)。スペースが存在しないとエラーですが、これはどうやって確かめることができるでしょうか?

[^\s]MB
または
\SMB

最初の記述は否定形になります。正規表現の先頭に「^」があると、文字列の先頭に一致する意味になってしまいましたね。そこで、クラスを示す [ ] で囲んで防いでいます。「^\sMB」とだけ記述すると文字列の先頭がスペースで、その後に「MB」が続くという意味になってしまいます。

2 つ目の [ ] かっこがないほうは、大文字の S になっていますね。そう、ややこしいですが、大文字の \S はスペース (空白文字) 以外を意味しますので最初から否定形になっています。正規表現では、同じエラーを検出するにしても、さまざまな表現ができてしまいます。ではさっそく「\SMB」で検索してみましょう。


このように、正しい記述以外すべてヒットしました。スペースのある/なしのスタイル違反は、この方法の応用で検出できます。本当は各種の空白文字を個別に指定した方が正確なのですが、ここでは省略しました。このあたりは、また後程・・・。

こんな感じで、気負わず今後も書いていきたいと思いまスルメ。

2010年9月15日水曜日

翻訳者と校正者のための正規表現 (1) - 基本

人間は誰でも間違いを犯します。タイポや誤変換をやっちまったことのない翻訳者や校正者はいないと思います。私も当然何回もやりました。「内臓ディスク」も納品しそうになったことがあります。

そこで、嫌な汗はかきたくないので、数年前から正規表現を勉強してエラーの防止に努めています。自分や他の翻訳者が犯したミスを分析し、次は必ず発見できるように、正規表現を使用しています。せっかくなので、ブログに残していきたいと思った次第です。

正規表現は CAT があれば一番楽に構成できますが、正規表現が可能なテキストエディタもあります。テキストエディタでは自動化は困難ですが・・・。

早速ですが、基本的な例から示していきたいと思います。次の画像は CAT でソースをターゲットにコピーする設定にしていたり、テキストを上書きで翻訳した場合によくあるミスです。よくあるって言っても、荒っぽい翻訳者で 1 万語で数個ぐらいでしょうか。

ピリオドが残っている例
上書き翻訳しているうちに、ピリオドが追い出されています。しかもカーソルが重なっているために見逃しやすくなっています。

そこで正規表現 。\. を使用します。この円 (機種によってはバックスラッシュ) マークは制御文字をエスケープする (普通の文字として扱う) ためのものです。英文記号には制御文字になっているものがあるので、これらを検出したいときは注意する必要があります。

また CAT ツールなどで各セグメントの末尾のピリオドのみを検出するには、\.$ を使用します。ドルマークは文末を示します。その直前にエスケープされたピリオドがあるので、文末のピリオドにヒットします。

日本語訳文の修正後には句点の連続がよくみられます。句点が 2 個連続しているだけなら 。。 または 。{2} です。ここで波かっこ内の数字は繰り返し数を示します。2 個以上のすべてを検出したいときは 。{2,}  になります。特殊な用途としては 。{3,6} と記述することで、3 個以上 6 個未満の連続句点にヒットします。

似たような、よくあるエラーを次に示します。

文末消し忘れ
これも日本語訳文の修正後によくみられるエラーです。句点の間に文字が入り込んでいます。これはどうしましょうか。

私は、 。.{0,5}。 を使用しています。エスケープされていないピリオドは「任意の文字」を示します。この正規表現を言葉にすると「句点間に 0 ~ 5 個の何らかの文字が入っている」という意味になります。これで何が検出されたかを次に示します。

範囲指定の応用
アンダーライン部分が検出部分を示しています。上限を 5 文字にしているのは、技術文書の日本語で 5 文字以内で句点が繰り返された場合、ほとんどがエラーですが、それ以上になると「。次を参照のこと。」などにヒットし始めます。

文芸などでは「よく寝た。おはよう。」などの表現があると思いますので、異なる数値が必要かもしれません。対象文書ごとに調整してみてください。

腹減ったので、今日はこの辺で。さいならさいなら。

2010年9月5日日曜日

TagEditor の QA Checker (正規表現) のススメ

注意: 詳細な操作方法は掲載してないです。興味を持っていただけて、実際にご自分で頑張って操作してみて作業が楽になったらうれしいな、という気持ちで書きました。

私は一応翻訳業なんです (笑)。CAT (Computer Aided/Assisted Translation) ツールを使っていない方は特に読んでいただかなくてもいいかも。

この世に CAT ツールは数あれど、ほぼ業界標準の地位を確立している SDL Trados、中でも TagEditor がお気に入りです。理由は QA Checker の強力さです。翻訳後にボタンをポチッで検出してくれますから。これに続くのは、同社の SDLX、Alchemy の Catalyst、LionBRIDGE (Geoworkz) の Translation Workspace と QA Tool 類、SDL 傘下に入った Idiom WorldServer でしょうか。あと、5年ぐらい前から地道に開発している KILGRAY の MemoQ とかも注目です。

その他にも某 OS 企業が推し進める LocalizationStudio や Helium とかも使っていますが、もう、操作を覚えるだけでお腹いっぱいですよ。初めてツール指定されたときはひっくり返りましたよw

で、何を書くかというと、TagEditor で実際にどのような正規表現を登録しているか、どういう利益があるかということです (回し者ではありません)。下のダイアログにたどり着くまでの操作は Web 上に結構存在すると思うので、そちらを検索してください (ちょっと不親切かな)。

ここで、スクリーンショットを数枚載せます (クリックで拡大できます)。一番左の列がスタイル違反とか、ケアレスミスの正規表現です。幸いというか、当たり前というか、日本語は制御文字に含まれていないので、そのまま記述すると検出してくれます。

基本的な記述
句読点の連続とか、使っちゃいけない漢字とかはそのまま記述。もちろん、クライアントごとに指定スタイルは変わりますよ。


基本的な記述2
そうそう、実は PM もやったことがあるんですが、複数の翻訳者にハンドオフした文章はこういった部分の揺れが激しいのです。

基本的な記述3

基本的な記述4
禁止表現やら差別表現やらを登録しておくと見逃しが少なくなります。もちろんですけど「時計が狂う」はアウトです。

こういった基本的なものを登録するだけで、余計な気を使う必要がなくなります。ただ登録には丸一日とか平気でかかりますので、リピートの多い最重要ソークラさん (年10万語以上) とかにお勧めします。

そして、正規表現が楽しくなってきたら、下記のような登録でさらにスタイルを詰めることができます。

ちょっと上級
左の列の長い表記はユニコードによる文字範囲指定です。見てもぐるぐるするだけなので (私もそうでした)、中央の列で何を検出しているかを見ていただければと思います。

QA Checker の潜在能力に気づいていただいて、そして実際に試行錯誤して使ってみて皆さんの翻訳人生が楽になることを願ってやみませんだみつお。